Дубли страниц — это адреса одного сайта с одинаковым содержимым. Они появляются из-за параметров в URL, настроек CMS и зеркал сайта. Найти их проще всего в Яндекс Вебмастере и Search Console, а убирают дубли редиректом 301, тегом canonical или директивой Clean-param. Выбор зависит от того, нужен ли адрес посетителям.
Ниже разберу, какие дубли бывают, где их искать и какой инструмент ставить в каждом случае. Перед правками важно одно: сначала посмотреть данные, потому что поспешная склейка отбирает трафик чаще, чем сами дубли.
Что считается дублем страницы
Яндекс называет дублями страницы одного сайта, доступные по разным адресам с одинаковым содержимым. Робот может объединить их в группу и оставить в поиске одну. Google делает то же самое и называет процесс канонизацией. Подробнее об этом механизме — в статье про canonical.
Чаще всего одна страница выглядит для робота так:
https://site.ru/divany/
https://site.ru/divany
https://www.site.ru/divany/
https://site.ru/divany/?utm_source=vk
https://site.ru/divany/?sort=price
На аудитах я делю дубли на три группы, потому что лечатся они по-разному.
Полные технические дубли. Содержимое совпадает целиком: версии с www и без, http и https, адрес со слешем на конце и без него, главная по адресу /index.php.
Дубли из-за параметров. Метки UTM, сортировка, идентификаторы сессий, параметры фильтров, которые не меняют список товаров.
Смысловые дубли. Разные адреса, почти один текст: товар лежит в нескольких категориях, теги и архивы в блоге повторяют рубрику, страницы услуги отличаются только названием города.
Третья группа самая спорная. Похожие страницы не всегда ошибка: если у них разный интент и каждая собирает свой спрос, склеивать их вредно. Яндекс отдельно уточняет, что региональные поддомены с одинаковым контентом дублями не считает.
Чем дубли вредят сайту
Штрафа за сам факт дублей я в документации не встречал. Проблемы у них практические, и Яндекс с Google описывают их почти одинаково:
- в поиск попадает не та страница, которую вы хотели показывать;
- адрес в выдаче меняется, и статистику становится трудно анализировать;
- дубли конкурируют между собой как отдельные документы;
- ссылки и другие сигналы размазываются по нескольким адресам;
- робот тратит обход на копии, а новые страницы ждут дольше.
У владельца сайта это выглядит так: позиция по важному запросу прыгает, а в отчётах за неё отвечают то карточка, то адрес с меткой. Для сайта на двадцать страниц это мелочь, а вот в интернет-магазине с фильтрами копии легко обгоняют по числу настоящие страницы.
Откуда берутся дубли
На сайтах клиентов я чаще всего нахожу одни и те же причины:
| Источник | Пример | Откуда растёт |
|---|---|---|
| Не настроено главное зеркало | site.ru и www.site.ru отвечают кодом 200 | Хостинг, настройки сервера |
| Слеш в конце адреса | /divany и /divany/ открываются оба | CMS, правила сервера |
| Рекламные метки | ?utm_source=vk, ?yclid=… | Реклама, рассылки |
| Сортировка и вид каталога | ?sort=price, ?view=list | Шаблон каталога |
| Товар в нескольких разделах | /divany/model/ и /akcii/model/ | Структура каталога |
| Служебные страницы CMS | теги, архивы автора, версия для печати | Настройки CMS |
| Тестовая копия сайта | dev.site.ru открыт для роботов | Разработка |
Как найти дубли страниц: четыре проверки
Начинаю всегда с данных поисковиков. Они показывают дубли, которые робот уже увидел, а значит, именно с этими адресами надо работать в первую очередь.
Яндекс Вебмастер
Откройте раздел «Страницы в поиске», вкладку «Исключённые страницы» и выберите статус «Удалено: Дубль». Тот же список можно выгрузить архивом: у дублей там статус DUPLICATE. Если копии создают GET-параметры, Вебмастер покажет уведомление в «Диагностике сайта». Где что лежит в кабинете, я разбирал в инструкции по Яндекс Вебмастеру.
Google Search Console
В отчёте об индексировании страниц смотрите три статуса:
| Статус | Что значит | Что делать |
|---|---|---|
| Вариант страницы с тегом canonical | Страница верно указывает на основную версию | Ничего |
| Страница является копией. Канонический вариант не выбран пользователем | Google сам выбрал другой адрес основным | Проверить выбор, при ошибке указать canonical |
| Страница является копией. Канонические версии страницы, выбранные Google и пользователем, не совпадают | Ваше указание не принято | Проверить адрес в инструменте проверки URL, сравнить содержимое страниц |
Сами по себе эти статусы не ошибка: копия просто не показывается в поиске. Тревожиться стоит, когда основным выбран не тот адрес.
Обход сайта краулером
Программы вроде Screaming Frog или SiteAnalyzer обходят сайт как робот и находят страницы с одинаковыми Title, H1 и содержимым. Так видно дубли, которые поисковик ещё не нашёл. Отсортируйте результат по Title и начните с самых больших групп совпадений.
Ручная проверка зеркал
Откройте в браузере четыре версии главной: http и https, с www и без. Потом внутреннюю страницу со слешем на конце и без него. Правильная картина: один адрес открывается, остальные перенаправляют на него кодом 301. Занимает это пару минут, а находит самый частый тип дублей.
Как убрать дубли: что выбрать
Вопрос, с которого стоит начинать, — нужен ли этот адрес человеку. От ответа зависит инструмент.
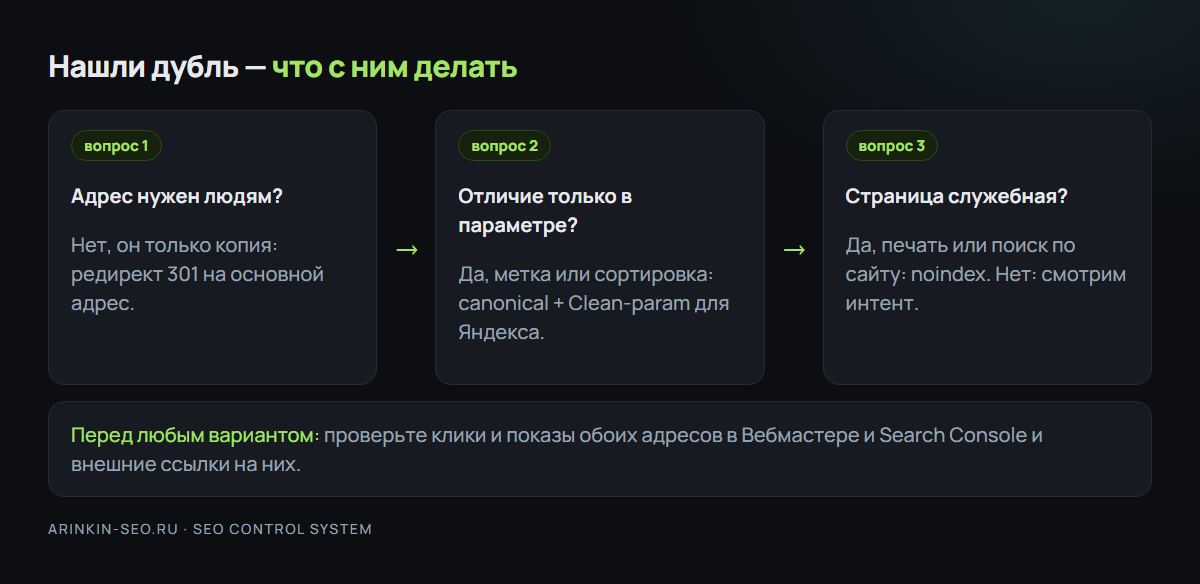
| Тип дубля | Решение | Комментарий |
|---|---|---|
| www, http, слеш в конце | Редирект 301 на основной адрес | Настраивается один раз правилом на весь сайт |
| Метки UTM и другие параметры | Clean-param для Яндекса и canonical | Адрес должен работать, рекламу ломать нельзя |
| Сортировка, вид каталога | Canonical на страницу без параметра | Clean-param тоже подходит |
| Товар в нескольких разделах | Один постоянный адрес товара или canonical | Лучше править структуру |
| Версия для печати, служебные страницы | Noindex | Сначала проверьте, что на них нет трафика |
| Тестовая копия сайта | Пароль на уровне сервера | Закрытие только в robots.txt ненадёжно |
| Пагинация каталога | Каждой странице свой canonical | Google не советует делать первую страницу канонической для всей серии |
Редирект 301
Посетитель и робот сразу попадают на нужный адрес, а копия уходит из поиска. Применяйте редирект, когда адрес больше не нужен. Настройка на разных серверах описана в инструкции по 301 редиректу. Яндекс при проблеме со слешем советует именно 301: canonical в этом случае может игнорироваться.
Canonical
Подходит, когда адрес должен работать для людей: страница с сортировкой нужна покупателю, но в поиске ей делать нечего. Google считает тег сильным сигналом, но окончательный выбор оставляет за собой. Основная страница ссылается на себя, адрес указывается полностью.
Clean-param
Директива для robots.txt, которую использует Яндекс. Она говорит роботу не учитывать незначащие параметры:
User-agent: Yandex
Clean-param: utm_source&utm_medium&utm_campaign /page
Без указания адреса правило работает на весь сайт. Google эту директиву не поддерживает, поэтому для него на тех же страницах нужен canonical. Как устроен файл целиком, я показывал в статье про robots.txt.
Robots.txt и noindex
Здесь поисковики расходятся. Яндекс перечисляет Disallow среди способов убрать дубль. Google не советует использовать robots.txt и noindex для выбора основной страницы: запрещённый адрес всё равно может попасть в индекс, а noindex полностью убирает страницу из поиска. Для служебных страниц noindex годится, для склейки дублей лучше 301 или canonical.
Где искать дубли на разных движках
У каждой CMS свои привычные источники копий. Когда знаешь их заранее, проверка занимает меньше времени.
| Движок | Что проверить в первую очередь |
|---|---|
| WordPress | Страницы вложений, архивы меток и авторов, параметр replytocom в комментариях, короткие адреса вида ?p=123 |
| 1С-Битрикс | Адреса с /index.php, параметры сортировки и фильтра, постраничная навигация вида ?PAGEN_1= |
| Самописный каталог | Один товар в нескольких разделах, регистр букв в адресе, параметры сессии |
| Конструкторы сайтов | Технические адреса страниц, тестовый поддомен, скрытые черновики в sitemap |
Для WordPress SEO-плагины обычно сами ставят canonical. Проверять всё равно стоит на готовой странице: откройте код и посмотрите, какой адрес указан и совпадает ли он с адресом в браузере.
С фильтрами каталога решение принимайте отдельно для каждого типа. Страница «диваны угловые» может собирать свой спрос, и тогда ей нужны собственный адрес, заголовок и текст, а закрывать её от поиска будет ошибкой. Комбинации вроде «цена по возрастанию, 48 на странице» спроса не имеют, им достаточно canonical. Границу здесь проводит семантика: сначала посмотрите, ищут ли такой вариант люди.
Частые ошибки при чистке дублей
Больше всего вреда я вижу от спешки. Владелец получает отчёт сервиса со списком «дублей» и за вечер склеивает всё подряд. Вот что проверяю перед правками:
- Какая версия получает клики и показы в Вебмастере и Search Console.
- На какой адрес ведут внешние ссылки и реклама.
- Разный ли интент у похожих страниц: если страницы собирают разный спрос, это не дубли.
- Нет ли канонического адреса, который ведёт на страницу с редиректом или с кодом 404.
- Совпадают ли сигналы: canonical, редирект, внутренние ссылки и sitemap.xml должны указывать на один адрес.
Отдельная грабля — склейка на страницу, которая слабее копии. Если поисковик показывает адрес с меткой и клики идут туда, сначала убедитесь, что на основной версии есть всё содержимое копии. Вторая частая ошибка — лечить следствие: убрать найденные копии и оставить шаблон, который их создаёт. Через месяц список вернётся.
Если дублей много и непонятно, где реальная проблема, а где шум отчёта, это отдельный блок в моём SEO-аудите сайта: смотрю данные поисковиков и даю приоритеты, что править первым. Для первого прохода подойдёт самостоятельный чек-лист.
Как не допустить новых дублей
Разовая чистка без профилактики быстро теряет смысл. Несколько правил закрывают большую часть случаев:
- На сайте один основной адрес: протокол, www и слеш на конце заданы правилом на сервере.
- На каждой индексируемой странице стоит canonical на саму себя.
- Внутренние ссылки ведут на основной адрес без меток и параметров.
- В sitemap.xml лежат только канонические адреса с кодом 200.
- Тестовая версия сайта закрыта паролем.
- Новые разделы и плагины проверяются сразу после запуска: открываете пару страниц и смотрите адреса и canonical.
Если сайт ведёт подрядчик, эти пункты удобно записать в требования к разработке. Исправить шаблон до запуска проще, чем потом разбирать тысячи адресов.
Как проверить, что дубли ушли
Изменения поисковик учтёт при следующем посещении сайта. Яндекс пишет, что ненужная страница выйдет из поиска в течение трёх недель, поэтому раньше этого срока делать выводы рано. Проверяйте результат так:
- В Вебмастере откройте «Страницы в поиске» и посмотрите, исчез ли адрес из индекса.
- В Search Console проверьте адрес и убедитесь, что выбранный Google канонический URL совпадает с вашим.
- Сравните клики и показы основной страницы до и после. Просадка в первые недели возможна, смотрите на тренд.
- Раз в квартал повторяйте обход краулером: новые дубли появляются вместе с новыми разделами и плагинами.
Проверю дубли на вашем сайте
Скиньте адрес сайта: бесплатно посмотрю, какие дубли мешают и что с ними делать в первую очередь
Получить разборили оставьте заявку на бесплатный разбор
Строю бизнесу управляемый канал клиентов из поиска: спрос → выдача → структура → упаковка → заявки. Кейсы в цифрах.
Источники
- Как удалить дубли страниц — Яндекс Вебмастер — что Яндекс считает дублями, как их найти и устранить
- Директива Clean-param — Яндекс Вебмастер — синтаксис директивы для незначащих параметров
- Как указать канонический URL — Google Search Central — способы склейки, сила сигналов и предупреждения
- Отчёт об индексировании страниц — Search Console — статусы про копии и канонические версии