Robots.txt — текстовый файл в корне сайта, который говорит поисковым роботам, какие разделы можно обходить, а какие нет. Правильная настройка: закрыть служебные страницы, корзину, фильтры с параметрами и поиск по сайту, оставить открытыми CSS, JS и все страницы, которые должны приносить трафик, и указать путь к sitemap.xml.
Ниже — как я настраиваю robots.txt на проектах, какие директивы реально работают в Яндексе и Google в 2026 году и какие ошибки в этом файле чаще всего нахожу на аудитах.
Что такое robots.txt и чего он не умеет
Файл лежит строго по адресу https://ваш-сайт.ru/robots.txt. Робот запрашивает его перед обходом и читает правила для своего user-agent. Если файла нет, сайт считается полностью открытым для обхода.
Главное, что владельцы сайтов понимают неправильно: robots.txt управляет обходом, а не индексом. Google прямо пишет в справке, что файл не предназначен для того, чтобы скрывать страницы из результатов поиска: закрытый URL может попасть в выдачу без описания, если на него ведут ссылки. Яндекс в своей справке говорит то же: чтобы убрать страницу из поиска, нужен noindex в HTML или HTTP-заголовке, и такую страницу нельзя закрывать в robots.txt, иначе робот не увидит директиву.
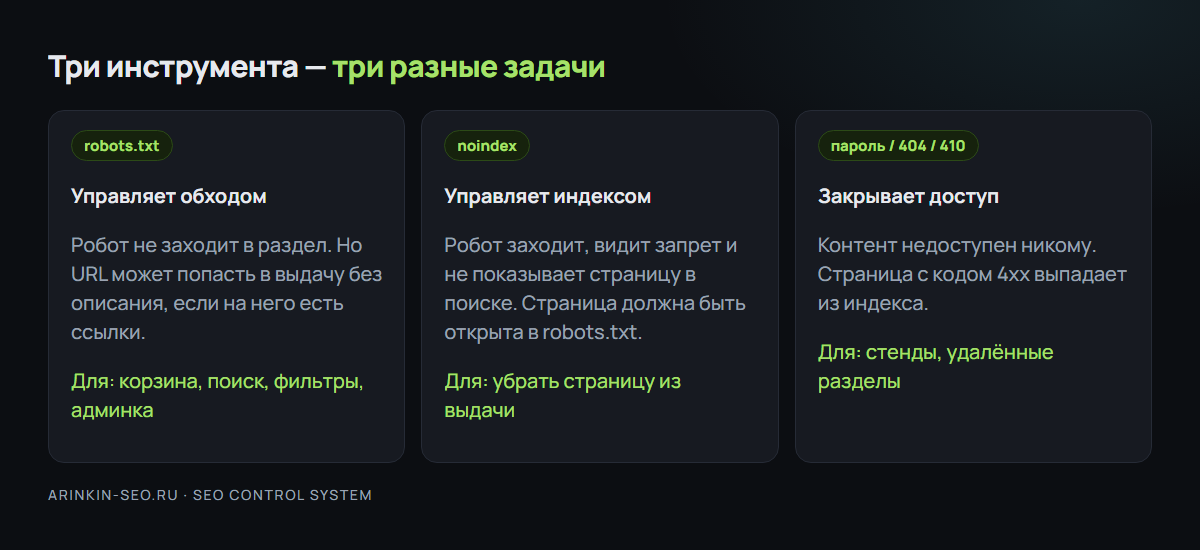
noindex и ждите, пока она выпадет. Закрывать её в robots.txt раньше — значит законсервировать в выдаче.Требования к файлу
| Требование | Яндекс | |
|---|---|---|
| Расположение | корень домена, имя строго robots.txt |
корень хоста (протокол + домен + порт) |
| Ответ сервера | 200 OK, иначе сайт считается открытым | 200; 4xx — как будто ограничений нет, 5xx — временно не сканирует |
| Размер | до 500 КБ | читается первые 500 КиБ |
| Кириллица | нельзя: домен в Punycode, пути в URL-кодировке | пути в URL-кодировке |
| Регистр | пути и имена файлов чувствительны к регистру | то же |
Отдельно про кириллицу: строка Disallow: /корзина не сработает. Нужно писать путь так, как он выглядит в закодированном URL (/%D0%BA%D0%BE...). На сайтах с кириллическими адресами я каждый раз проверяю это первым делом.
Директивы: что работает в 2026 году
User-agent
Указывает, к какому роботу относится группа правил. User-agent: * — ко всем, User-agent: Yandex — к роботам Яндекса, User-agent: Googlebot — к основному роботу Google. Робот выбирает самую конкретную группу, которая к нему подходит, а остальные игнорирует. Отсюда частая ошибка: владелец пишет отдельную группу для Яндекса, а общие запреты остаются только в * — и Яндекс их уже не видит.
Disallow и Allow
Disallow запрещает обход пути, Allow разрешает. Оба поддерживают * (любая последовательность символов) и $ (конец адреса). При конфликте побеждает более длинное, то есть более точное правило.
Sitemap
Путь к XML-карте сайта, полный URL с протоколом. Можно указать несколько строк. Подробно про карту — в статье Sitemap.xml: как создать и отправить в Яндекс и Google.
Clean-param
Директива только для Яндекса. Говорит роботу, что параметры вроде utm_source, sort, ref не меняют содержание страницы, и он склеивает такие адреса с основным. Для интернет-магазинов и сайтов с рекламными метками это один из самых полезных инструментов в файле:
Clean-param: utm_source&utm_medium&utm_campaign&utm_content&utm_term
Что уже не нужно
Host Яндекс больше не учитывает: главное зеркало определяется по 301-редиректу и настройкам в Вебмастере. Crawl-delay Google не поддерживает. Если встречаете эти строки в старых шаблонах — они не вредят, но и ничего не делают.
Что закрывать, а что оставлять открытым
Закрывать имеет смысл то, что не несёт ценности в поиске и тратит обход робота:
- админку, личный кабинет, корзину и оформление заказа
- внутренний поиск по сайту (
/search/,?q=) - страницы сравнения, печатные версии, служебные скрипты
- дубли с параметрами сортировки и фильтров, которые не являются посадочными
- тестовые разделы и стенды
Не закрывать:
- CSS, JS, шрифты и изображения. Роботы рендерят страницу, и закрытые стили ломают оценку мобильной версии.
- Фильтры, которые вы специально продвигаете как посадочные (например, «диваны зелёные»).
- Страницы пагинации каталога без отдельной стратегии — иначе товары глубже первой страницы робот будет находить хуже.
Disallow: /. Сайт полностью закрыт, а владелец неделями ищет причину падения в текстах.Пример robots.txt для сайта услуг
Ниже — базовый вариант, от которого я отталкиваюсь на сайтах услуг и небольших магазинах. Это не шаблон «вставить и забыть»: пути нужно сверить со своей CMS.
``` User-agent: * Disallow: /admin/ Disallow: /cart/ Disallow: /checkout/ Disallow: /search/ Disallow: /?sort= Disallow: /?q= Allow: /.css Allow: /.js
User-agent: Yandex Disallow: /admin/ Disallow: /cart/ Disallow: /checkout/ Disallow: /search/ Clean-param: utm_source&utm_medium&utm_campaign&utm_content&utm_term Clean-param: sort
Sitemap: https://ваш-сайт.ru/sitemap.xml ```
Обратите внимание: в группе Yandex запреты продублированы. Если этого не сделать, робот Яндекса прочитает только свою группу и пойдёт в корзину и поиск.
Особенности CMS
- WordPress по умолчанию отдаёт виртуальный robots.txt. Если положить физический файл в корень, он заменит виртуальный. SEO-плагины тоже умеют его править — главное, чтобы источник правды был один.
- Tilda формирует файл сама, а собственные правила добавляются в настройках сайта.
- 1С-Битрикс имеет встроенный редактор robots.txt в модуле поисковой оптимизации.
Как проверить robots.txt
- Откройте
ваш-сайт.ru/robots.txtв браузере. Файл должен открываться, без редиректа на главную и без HTML-разметки. - В Яндекс Вебмастере — инструмент «Анализ robots.txt»: показывает, какие строки распознаны, и позволяет проверить, разрешён ли конкретный URL. Код ответа самого файла смотрите в «Проверке ответа сервера».
- В Google Search Console — отчёт о файлах robots.txt в настройках: какие версии файла Google получил и были ли ошибки при загрузке.
- Прогоните 10–20 ключевых URL (главная, услуги, категории, карточки) через проверку разрешений. Если хоть одна посадочная страница закрыта — это приоритет номер один.
Ошибки в robots.txt редко живут поодиночке: рядом обычно находятся проблемы с sitemap, canonical и редиректами, поэтому в SEO-аудите сайта я проверяю их вместе. Как вписать проверку robots.txt в общий разбор сайта, я показывал в материале SEO-аудит сайта самостоятельно.
Частые ошибки в robots.txt
| Ошибка | Что происходит | Как исправить |
|---|---|---|
Disallow: / остался после разработки |
сайт выпадает из обхода целиком | убрать строку, отправить главные страницы на переобход |
| Закрыты CSS/JS | робот видит «сломанную» страницу | удалить запреты на /wp-content/, /assets/ и т. п. |
| Через robots.txt пытаются убрать страницы из индекса | страницы висят в выдаче без описания | открыть, поставить noindex, дождаться выпадения |
| Отдельная группа для Яндекса без общих запретов | Яндекс обходит корзину и поиск | дублировать нужные правила в каждой группе |
| Кириллица в путях | правило не работает | писать пути в URL-кодировке |
| Файл отдаёт 404 или 500 | правила не применяются | настроить ответ 200 |
Проверю robots.txt и индексацию вашего сайта
Скиньте адрес — бесплатно посмотрю, не закрыто ли лишнее и куда уходит обход робота
Получить разборили оставьте заявку на бесплатный разбор
Строю бизнесу управляемый канал клиентов из поиска: спрос → выдача → структура → упаковка → заявки. Кейсы в цифрах.
Источники
- Использование файла robots.txt — Яндекс Вебмастер — требования к файлу, директивы, Clean-param, кириллица
- Общие сведения о файлах robots.txt — Google Search Central — почему robots.txt не скрывает страницы из поиска
- Как Google интерпретирует спецификацию robots.txt — синтаксис, приоритет правил, коды ответа и кэширование