Страницы не индексируются по пяти группам причин: сервер отдаёт ошибку или редирект, страница закрыта в robots.txt или метатегом noindex, поисковик считает её дублем другой страницы, робот не находит её по ссылкам и sitemap, или алгоритм решил, что она малоценна. Причину для каждой страницы показывают Яндекс Вебмастер и Google Search Console — с них и начинается диагностика.
Ниже — порядок проверки, которым я пользуюсь на аудитах, расшифровка статусов обеих систем и что делать в каждом случае.
Сначала убедитесь, что проблема есть
Новая страница не появляется в поиске мгновенно. Яндекс пишет, что после исправления причины страница может вернуться в поиск в течение двух недель. Google — что повторное сканирование занимает от нескольких дней до нескольких недель. Если страница опубликована вчера, это не проблема индексации, а очередь.
Как проверить, есть ли страница в индексе:
- Яндекс Вебмастер → «Индексирование» → «Страницы в поиске»: поиск по адресу среди проиндексированных и исключённых.
- Google Search Console → «Проверка URL»: вставьте адрес и посмотрите статус.
- Быстрый способ — оператор
site:с адресом страницы в поиске, но он даёт приблизительный результат. Опираться лучше на панели вебмастеров.
Порядок диагностики
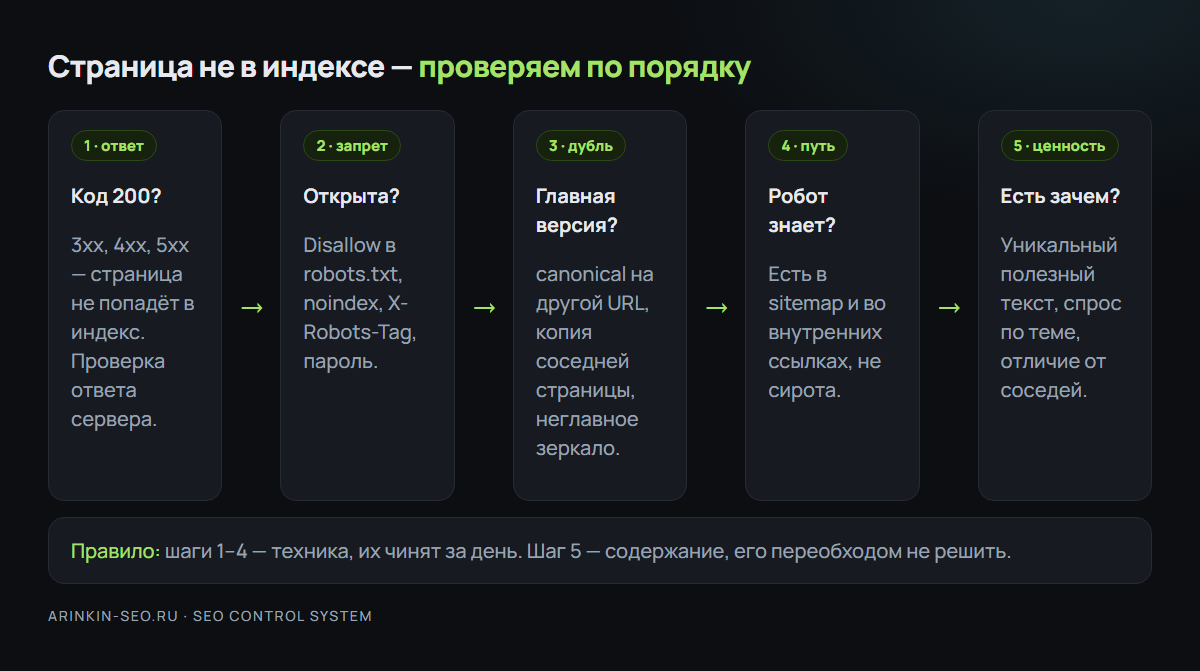
Я иду по шагам от простого к сложному: технические причины находятся и исправляются быстро, а проблемы с содержанием требуют переработки страницы.
Шаг 1. Код ответа сервера
Страница должна отдавать код 200. Если она отдаёт 301 или 302, в индекс попадёт адрес, на который ведёт редирект. Если 404 или 410 — страницы для поиска нет. Если 5xx — сервер ошибается, и робот не может получить содержимое. Что делать с самой частой из них, разобрал в статье про ошибку 500.
Где смотреть: в Вебмастере — «Проверка ответа сервера», в Search Console — «Проверка URL». Частая находка: страница открывается в браузере, а роботу отдаёт ошибку из-за защиты от ботов на хостинге или из-за долгого ответа сервера.
Шаг 2. Запреты индексации
Проверьте четыре места:
- robots.txt — нет ли правила Disallow, под которое попадает адрес;
- метатег robots в коде страницы — нет ли
noindexилиnone; - HTTP-заголовок X-Robots-Tag — его не видно в коде страницы, только в ответе сервера;
- авторизация — не закрыт ли раздел паролем.
Типичный сценарий: сайт разрабатывали на тестовом адресе и закрыли от индексации, а при переносе на боевой домен галочку «запретить индексацию» в CMS забыли снять. Как правильно настроить robots.txt — в отдельной статье про robots.txt.
Шаг 3. Дубли и canonical
Если у страницы стоит rel="canonical" на другой адрес, поисковик проиндексирует другой адрес. Если страница почти полностью повторяет соседнюю, поисковик выберет одну из них сам. Сюда же относятся адреса с параметрами, версии со слешем и без, http и https, www и без www.
Что проверить: куда указывает canonical на странице, нет ли на сайте второй страницы с тем же текстом, какое зеркало сайта считается главным.
Шаг 4. Знает ли робот о странице
Страница-сирота, на которую не ведёт ни одна ссылка и которой нет в sitemap, может годами оставаться неизвестной поисковику. Это частая история с посадочными страницами под рекламу, которые потом решили продвигать в поиске.
- добавьте страницу в sitemap.xml (как его собрать — в статье про sitemap.xml);
- поставьте на неё ссылки из меню, раздела или связанных страниц;
- отправьте адрес на переобход в Вебмастере и запросите индексирование в Search Console.
Шаг 5. Ценность страницы
Если технически всё в порядке, а страница всё равно не в индексе, причина почти всегда в содержании. В Яндексе это статус «малоценная или маловостребованная страница», в Google — «Просканирована, но пока не проиндексирована».
Яндекс объясняет: алгоритм считает, что у страницы мало шансов понравиться пользователям — в ней нет содержимого, она повторяет уже известные страницы или не отвечает интересам аудитории. Google для этого статуса не советует повторно запрашивать сканирование — нужно улучшать содержание и уникальность.
На аудитах такие страницы обычно выглядят так: десять страниц услуг по городам с одинаковым текстом, где меняется только название города; карточки товаров с описанием от производителя; статьи по 200 слов «для SEO». Решение — не переобход, а переработка: уникальное содержание, ответ на реальный вопрос, понятная роль страницы на сайте.
Статусы в Яндекс Вебмастере и что делать
| Статус | Что значит | Что делать |
|---|---|---|
| Ошибка загрузки | Код 3xx, 4xx или 5xx | Проверить ответ сервера, исправить ошибку или редирект |
| Запрет индексирования | Disallow в robots.txt или noindex | Снять запрет, если страница нужна в поиске |
| Редирект | Страница перенаправляет на другой адрес | Убедиться, что редирект задуман |
| Дубль | Содержимое совпадает с другой страницей | Сделать страницу уникальной или выбрать главную |
| Неканоническая | canonical указывает на другой URL | Исправить canonical, если он стоит ошибочно |
| Малоценная или маловостребованная | Алгоритм не видит пользы | Переработать содержание и роль страницы |
| Неглавное зеркало | Сайт признан неглавным в группе | Проверить настройку зеркал |
Все статусы видны в разделе исключённых страниц. Подробно о работе с отчётами — в статье про Яндекс Вебмастер.
Статусы в Google Search Console и что делать
Статусы видны в отчёте «Индексирование страниц». Если вы ещё не настроили сервис, начните с инструкции по Google Search Console.
| Статус | Что значит | Что делать |
|---|---|---|
| Обнаружена, не проиндексирована | Google знает адрес, но ещё не сканировал | Обычно ждать; проверить нагрузку сервера и внутренние ссылки |
| Просканирована, но пока не проиндексирована | Просканирована, но не добавлена | Улучшить содержание; повторный запрос не нужен |
| Страница содержит директиву noindex | Стоит noindex | Удалить, если страница нужна в индексе |
| Доступ заблокирован в файле robots.txt | Обход запрещён | Убрать правило, если страница нужна |
| Копия без выбранного пользователем канонического варианта | Google выбрал другой URL главным | Указать верный canonical, сделать контент отличным |
| Ложная ошибка 404 | Страница пустая, но отдаёт 200 | Наполнить страницу или отдавать настоящий 404 |
| Ошибка сервера (5xx) | Сервер не ответил | Проверить сервер и стабильность хостинга |
Когда проблема не у страницы, а у всего сайта
Если из индекса выпала не одна страница, а большая часть сайта, проверьте сразу:
- Раздел нарушений в Вебмастере и «Меры, принятые вручную» в Search Console. Если запись есть, порядок действий описан в статье про фильтры Яндекса.
- Срок регистрации домена — Яндекс прямо упоминает это в справке среди причин.
- robots.txt целиком — одна строка
Disallow: /закрывает весь сайт. - Последние изменения — переезд, редизайн, смена CMS, подключение CDN или защиты от ботов.
Массовое выпадение страниц — повод для полного разбора, а не для точечных исправлений. В таких случаях я начинаю с SEO-аудита: технические причины, дубли и качество содержимого смотрятся вместе, иначе исправление одного ломает другое.
Частые ошибки при борьбе с неиндексацией
- Многократная отправка на переобход. Если страница малоценна, переобход её не спасёт.
- Удаление «лишних» исключённых страниц. Пагинация, фильтры и служебные адреса и должны быть вне индекса. Решения об удалении и склейке страниц принимаются по данным о трафике и позициях.
- Массовое размножение страниц. Двадцать одинаковых страниц под районы города чаще всего уходят в малоценные.
- Исправление в одной системе. Починили для Google, а в Яндексе страница исключена по другой причине.
Страницы сайта не попадают в индекс?
Пришлите сайт — найду причину по данным Вебмастера и Search Console и скажу, что исправить первым
Получить разборили оставьте заявку на бесплатный разбор
Строю бизнесу управляемый канал клиентов из поиска: спрос → выдача → структура → упаковка → заявки. Кейсы в цифрах.
Источники
- Почему страницы исключены из поиска — справка Яндекс Вебмастера
- Отчёт об индексировании страниц — статусы Search Console
- Проблемы с индексированием сайта — справка Search Console